数据结构|排序(四):归并排序详解——递归分治、非递归迭代与 gap 边界处理
本文是排序专题第四篇,讲解归并排序的递归分治与非递归迭代两种实现。剖析闭区间 [begin,mid] 与 [mid+1,end] 划分要点,说明需要 O (N) 辅助数组的原因。重点解析自底向上 gap 迭代逻辑,处理数组末尾两组缺失、右组不完整两类边界。对比递归与非递归本质,区分归并与快排的设计差异,讲解稳定性细节。代码先搭建独立 MergeSort 工程,再接入综合排序框架,依托十万随机数据完成计时与有序校验。
写在前面
前面的排序专题中,我们已经依次学习了基础排序算法、快速排序,以及快速排序中不同的划分方式和递归/非递归实现。
这一篇进入另一种非常经典的 O(N logN) 排序算法——归并排序(Merge Sort)。
归并排序和快速排序一样,都建立在分治思想之上,但二者的思路刚好有很明显的区别:
快速排序:先划分,再递归处理左右区间
归并排序:先递归让左右区间分别有序,再把两个有序区间合并这次我先单独建立了一个MergeSort工程,拆分为:
MergeSort.h
MergeSort.c
merge_test.c
并实现两套版本:
void MergeSort(int* a, int n);      // 递归版
void MergeSortNonR(int* a, int n); // 非递归迭代版其中递归版本重点理解:[begin, mid]与[mid + 1, end]的区间边界。 非递归版本重点理解:gap从 1 开始不断翻倍,以及数组末尾不够两组数据时的边界修正。
当前独立MergeSort工程中的两个接口也已经这样声明。此外,这两个版本已经同步加入原来的SortComparison综合排序工程,继续使用10 万随机整数 + 相同输入数组 + 运行时间统计 + Check 有序性验证进行测试。
代码仓库:
数据结构/MergeSort · Luminous/Code_2026 - 码云 - 开源中国
SortComparison 排序算法综合工程 原本已经包含冒泡、插入、希尔、堆、双向选择以及快速排序等,本次又把两种新快排同步加入统一性能测试。
代码仓库:
数据结构/SortComparison · Luminous/Code_2026 - 码云 - 开源中国
两个工程出现相同算法并不是重复:一个负责专项学习,一个负责汇总进完整排序算法体系。
一、归并排序核心:分治思想与辅助数组
1.1 归并的基本过程
归并排序名字里的“归并”,本质就是:把两个已经有序的区间,合并成一个更大的有序区间。
例如现在有两个有序数组:
左区间:1 4 7
右区间:2 3 8
我们分别设置两个指针:
1 4 7
↑
begin1

2 3 8
↑
begin2比较两个指针当前指向的元素:1 < 2,先取1,tmp:1,左边指针后移。 继续比较:2 < 4,取2,tmp:1 2。 依次类推,最终得到完整有序序列:1 2 3 4 7 8。
所以归并排序真正的基础并不是递归,而是:两个有序区间如何在线性时间内合并。
1.2 为什么需要辅助数组
假设:
左区间:1 5 8
右区间:2 4 7
如果直接在原数组里一边比较、一边覆盖,就有可能把后面尚未参与比较的数据提前覆盖掉。
因此当前实现额外申请辅助空间:
int* tmp = (int*)malloc(sizeof(int) * n);所有比较结果先写到tmp中,当前区间合并结束以后,再统一写回原数组:
for (int i = begin; i <= end; i++)
{
    a[i] = tmp[i];
}递归版本正是先把结果放入tmp,再把[begin,end]区间拷回原数组。因此归并排序和堆排序、快速排序一个非常明显的区别是:它不是原地排序,需要额外的 O(N) 辅助空间。
二、递归版归并排序:拆分与归并的完整流程
递归版本的总体结构非常清楚:
MergeSort
    ↓
把区间一分为二
    ↓
递归排序左半区间
    ↓
递归排序右半区间
    ↓
合并两个有序区间
2.1 分治拆分的过程
例如数组8 3 6 1 5 7 2 4:
- 第一层:
8 3 6 1 | 5 7 2 4 - 第二层:
8 3 | 6 1 | 5 7 | 2 4 - 继续拆分:
8 | 3 | 6 | 1 | 5 | 7 | 2 | 4
当每个区间只剩一个元素时,单个元素天然有序。接下来开始从底层向上归并:
8 + 3 → 3 86 + 1 → 1 6- 继续向上合并,最终得到整个有序数组。
2.2 区间边界的正确写法
当前递归函数的核心拆分逻辑:
static void _MergeSort(int* a, int* tmp, int begin, int end)
{
    if (begin >= end)
        return;

    int mid = (begin + end) / 2;

    _MergeSort(a, tmp, begin, mid);
    _MergeSort(a, tmp, mid + 1, end);
}这里一定要明确:左区间:[begin, mid],右区间:[mid + 1, end]而不是[begin, mid - 1]和[mid + 1, end]。
为什么左区间必须到 mid?
例如begin = 0,end = 7,则mid = 3。 正确拆分:[0,3]和[4,7],刚好覆盖0 1 2 3 4 5 6 7。 如果误写成[0,2]和[4,7],下标 3 会被直接漏掉。
因此这里本质上是一个闭区间设计:父区间[begin,end]两端都包含,拆开以后也必须保证「左区间 ∪ 右区间 = 原区间,没有重叠、没有遗漏」,所以自然得到[begin,mid]和[mid+1,end]。
2.3 递归出口与执行顺序
当begin == end时,区间里只有一个元素,天然有序,不需要继续拆分,直接返回:
if (begin >= end)
{
    return;
}
这就是递归的最小子问题。整个归并排序的递归过程可以理解成:
大区间 → 两个小区间 → 更小区间 → 单元素 → 开始向上归并这点和快速排序很不一样:快速排序的核心工作主要发生在递归之前的 Partition;而归并排序最重要的工作发生在左右递归完成之后的 Merge。
2.4 完整归并过程的三步逻辑
int begin1 = begin, end1 = mid;
int begin2 = mid + 1, end2 = end;
int j = begin;

while (begin1 <= end1 && begin2 <= end2)
{
    if (a[begin1] < a[begin2])
        tmp[j++] = a[begin1++];
    else
        tmp[j++] = a[begin2++];
}

while (begin1 <= end1)
    tmp[j++] = a[begin1++];

while (begin2 <= end2)
    tmp[j++] = a[begin2++];

for (int i = begin; i <= end; i++)
    a[i] = tmp[i];
整个流程可以拆成三个步骤:
- 两边都有数据:不断比较只有左区间、右区间都还有元素时,才需要继续比较大小,每次取两边较小值放入 tmp。
- 某一边先走完:剩余数据直接复制假设左区间先结束,剩下的右区间本身已经有序,不需要再比较,直接批量复制进 tmp;左边同理。
- 最后统一写回原数组此时
[begin,end]已经整体有序,于是上一层递归就可以把它作为一个更大的有序子区间,继续参与下一次归并。
2.5 对外接口的内存设计
当前对外接口:
void MergeSort(int* a, int n)
{
    int* tmp = (int*)malloc(sizeof(int) * n);

    if (tmp == NULL)
    {
        perror("malloc tmp fail");
        return;
    }

    _MergeSort(a, tmp, 0, n - 1);

    free(tmp);
}只在最外层申请一次辅助数组,然后把同一个tmp传入所有递归层,所有递归层共同复用,排序完成统一 free。
如果每进入一次_MergeSort()都 malloc,会产生大量反复的内存申请和释放;而只申请一次的设计更加合理,也避免了重复开销。
三、非递归版归并排序:自底向上的gap迭代
3.1 为什么不用栈模拟递归
看到递归算法以后,很容易产生一个想法:快速排序非递归可以用栈,那么归并排序是不是也可以用栈模拟递归?
理论上当然可以,但是这里并不推荐。因为归并排序本身拥有一个比“模拟递归”更加自然的非递归规律:从最小的有序区间开始,两两归并,不断把区间长度翻倍。
单个元素天然有序,我们根本不需要通过栈去模拟“拆到最底层”,直接从底层开始即可。
3.2 gap变量的含义与迭代过程
核心变量:
int gap = 1;这个gap表示:当前每个有序小组最多包含多少个元素。
初始gap = 1,每 1 个元素一组,单元素天然有序。
- 第一轮
gap=1:两两归并,得到每组 2 个元素的有序区间 - 第二轮
gap=2:两两归并,得到每组 4 个元素的有序区间 - 第三轮
gap=4:两两归并,得到每组 8 个元素的有序区间 - ……
每轮结束执行:
gap *= 2;外层循环终止条件:
while (gap < n)当gap >= n时,意味着当前一个有序区间已经足以覆盖整个数组,排序完成。
3.3 循环结构与区间定义
一次归并需要两组数据,所以一次最多处理 个数据,内层循环步长为
2 * gap:
for (int i = 0; i < n; i += 2 * gap)四个边界定义:
int begin1 = i;
int end1 = i + gap - 1;

int begin2 = i + gap;
int end2 = i + 2 * gap - 1;
也就是:
- 第一组:
[i, i+gap-1] - 第二组:
[i+gap, i+2*gap-1]
所有区间依然使用闭区间,和递归版本的区间设计保持一致。
3.4 两类边界越界的处理
如果数组长度刚好是 2 的整数次幂,归并会非常规整。但现实中 n 可以是任意数字,最后一组往往凑不够完整的两组,这正是非递归归并里最需要处理的边界问题。
第一种越界:第二组根本不存在
如果begin2 >= n,说明第二组起点已经跑到数组外面,剩下的数据本来就已经是上一轮归并得到的有序小组,没有必要再操作。
if (begin2 >= n)
{
    break;
}
第二种越界:右组存在,但不完整
begin2 < n说明第二组确实存在,但end2可能超过n - 1。 例如n=10,gap=4,i=4,理论第二组是[8,11],但数组最大下标只有 9,因此第二组实际上应该修正为[8,9]。
if (end2 >= n)
{
    end2 = n - 1;
}为什么不需要额外判断end1?
因为begin2 = end1 + 1,只有begin2 < n时才会进入真正的归并;既然begin2 < n,自然说明end1 = begin2 - 1 < n,所以end1必然合法。
3.5 完整非递归代码逻辑
void MergeSortNonR(int* a, int n)
{
    int* tmp = (int*)malloc(sizeof(int) * n);
    if (tmp == NULL)
    {
        perror("malloc tmp fail");
        return;
    }

    int gap = 1;
    while (gap < n)
    {
        for (int i = 0; i < n; i += 2 * gap)
        {
            int begin1 = i;
            int end1 = i + gap - 1;
            int begin2 = i + gap;
            int end2 = i + 2 * gap - 1;

            if (begin2 >= n)
                break;
            if (end2 >= n)
                end2 = n - 1;

            int j = i;
            while (begin1 <= end1 && begin2 <= end2)
            {
                if (a[begin1] < a[begin2])
                    tmp[j++] = a[begin1++];
                else
                    tmp[j++] = a[begin2++];
            }
            while (begin1 <= end1)
                tmp[j++] = a[begin1++];
            while (begin2 <= end2)
                tmp[j++] = a[begin2++];

            for (int k = i; k <= end2; k++)
                a[k] = tmp[k];
        }
        gap *= 2;
    }
    free(tmp);
}整个非递归版本其实可以浓缩成一句话:把递归版本“先拆到底再向上合并”的过程,直接反过来从底层开始执行。
四、算法分析与横向对比
4.1 递归与非递归的本质联系
两套代码表面上差别非常大:
- 递归版:向下拆分 → 拆到单元素 → 递归回退 → 两两归并
- 非递归版:直接从单元素天然有序这个事实开始,按 gap=1、2、4、8…… 逐层向上合并
也就是说:非递归版并不是换了一种排序算法,而是把递归返回阶段的归并顺序直接显式写成循环。
这也对应了上一篇快速排序的对比:快速排序产生的子区间位置并不规则,所以显式栈很自然;而归并排序每一层区间长度具有固定的 1、2、4、8……规律,直接使用 gap 自底向上循环反而更加清晰。
4.2 时间与空间复杂度
时间复杂度
无论递归还是非递归,每一轮归并所有区间加起来基本都会处理整个数组,一层成本 O(N);区间大小不断翻倍,总共需要 层。
因此: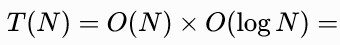
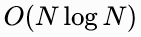
递归版、非递归版时间复杂度相同。
空间复杂度
两种版本都申请长度为 n 的辅助数组,主要辅助空间为 (\boxed{O(N)})。
除此之外,递归版本还存在 O(log N) 的递归调用栈,但大 O 中 O(N)+O(log N)=O(N),因此整体额外空间仍然记作 O(N);非递归版则没有这一层函数递归栈。
4.3 稳定性细节说明
理论上的归并排序可以做到稳定。但当前代码中使用的是严格小于<:
if (a[begin1] < a[begin2])假设左右两侧出现两个相等元素,由于5A < 5B为假,代码会先取右边的 5B,相同元素的相对顺序可能发生改变。
如果要保证稳定排序,建议把两处比较改成:
if (a[begin1] <= a[begin2])遇到相等元素时优先取左区间原本靠前的元素,才能保留原有相对顺序。
4.4 与快速排序的横向对比
| 对比维度 | 快速排序 | 归并排序 |
|---|---|---|
| 核心思想 | 先划分,再递归 | 先递归,再合并 |
| 平均时间 | O(N logN) | O(N logN) |
| 最坏时间 | O(N^2) | O(N logN) |
| 数组额外空间 | 较少 | O(N) |
| 是否原地排序 | 是 | 数组版否 |
| 稳定性 | 不稳定 | 可实现稳定 |
| 非递归思路 | 显式栈保存区间 | gap 自底向上翻倍 |
这一对算法特别适合放在一起学习:快速排序的难点主要在 Partition,归并排序的难点主要在 Merge 和区间边界。
五、工程实现与统一测试
5.1 独立MergeSort工程
本次先建立单独工程,包含MergeSort.h、MergeSort.c、merge_test.c。头文件声明了随机数组生成、有序性检查以及递归/非递归两个归并接口。
独立测试继续沿用之前 QuickSort 专项工程的方式:
srand((unsigned int)time(NULL));
const int N = 10000;
先生成同一份 origin,然后每个版本测试前 memcpy 复原原始数据,保证递归版和非递归版面对完全相同的数据。测试代码分别调用两个接口,并通过Check()校验最终是否升序。
5.2 同步接入SortComparison综合测试
独立实现正确以后,再同步进原来的综合排序工程。sort.h新增两个函数声明,sort.c末尾加入_MergeSort、MergeSort、MergeSortNonR三部分实现。
性能测试继续作为第 13、14 组,统一放入 10 万随机数据测试。这样当前综合工程已经不仅能比较冒泡、插入、希尔、堆排序、双向选择、快速排序,还正式加入了归并排序。
六、核心易错点与总结
归并排序和快速排序一样属于非常典型的分治算法,但两者的关注点完全不同。
递归归并排序的核心流程是「拆左边 + 拆右边 + 合并两个有序区间」,最关键的区间关系是[begin,mid]和[mid+1,end]。
而非递归归并排序则把“递归拆到底再返回”的过程反过来,从 gap=1 开始自底向上迭代,每一轮将两个 gap 大小的有序区间合并成一个 2*gap 的有序区间。
其中真正容易写错的并不是归并本身,而是数组末尾不够完整两组时的边界问题:
begin2 >= n→ 根本没有右组,直接跳出end2 >= n→ 右组存在,但长度不足 gap,修正终点
另外还有两个重要结论:
- 取消递归并不等于一定要用栈。快速排序子区间不规则,适合用栈;归并排序层级规律,适合用 gap 迭代。
- 归并排序可以是稳定排序,但需要相等元素时优先取左区间元素,使用
<=而非<。
独立MergeSort工程完成后,再把两个版本同步回SortComparison,也继续保持了目前整个排序学习项目的思路:先单独实现、搞懂算法,再统一接入 10 万数据性能测试进行横向比较。