数据结构|排序(一):基础排序算法横向对比——冒泡、插入、希尔、堆与双向选择,详解二分和 Knuth 增量
本文为排序专题开篇,在统一工程中实现冒泡、直接插入、双向循环选择、堆排序,以及二分、Knuth两种增量的四版希尔排序,使用十万随机数组做公平性能对比。讲解希尔排序分组预排序思想,辨析三重分组与二重交叉实现差异,剖析双向选择排序下标修正的易错坑点。梳理各算法时间、空间复杂度与稳定性,借助实测直观展现O(N²)与O(NlogN)的性能差距,为后续快排、归并排序学习打下基础。
写在前面
前面学习堆的时候,我们已经接触过堆排序,并知道利用大根堆可以完成升序排序。但排序并不只有一种实现方式,不同算法在思想、时间复杂度、空间复杂度以及真实运行效率上都有明显差异。
这次我把目前学习到的几种排序算法统一整理到一个工程中,使用同一组10 万个随机整数进行性能测试。目前工程共测试 8 组实现:冒泡排序、直接插入排序、堆排序、两种二分增量希尔排序、两种 Knuth 风格增量希尔排序,以及双向循环选择排序。每一种排序开始前都重新memcpy原始数组,保证比较时输入数据完全一致。
本文重点不只是比较谁更快,而是梳理:
- 冒泡、直接插入、双向循环选择排序分别是怎样一步步完成排序的;
- 希尔排序为什么本质上是“分组的插入排序”;
- 三重分组写法和二重交叉写法有什么区别;
gap /= 2与本文代码中的gap = gap / 3 + 1有什么差异;- 为什么希尔排序最后必须执行
gap = 1; - 双向循环选择排序为什么必须修正
maxi下标; - 堆排序为什么能稳定保持 (O(N\log N));
- 最后通过统一测试框架观察各算法的实际性能。
代码仓库
数据结构/SortComparison · Luminous/Code_2026 - 码云 - 开源中国
一、工程结构与性能测试方式
本次工程仍然采用之前一直使用的三文件结构:
| 文件 | 作用 |
|---|---|
| sort.h | 排序函数、辅助函数声明 |
| sort.c | 所有排序算法具体实现 |
| sort_test.c | 生成随机数组、统一计时、结果校验 |
目前sort.h已经统一声明了冒泡、双向循环选择、直接插入、4 种希尔排序以及堆排序接口。
测试数据规模为:
const int N = 100000;随机种子使用当前时间:
srand((unsigned int)time(NULL));然后生成一份原始数组:
int* origin = GenArray(N);
int* tmp = (int*)malloc(sizeof(int) * N);
这里有一个比较重要的测试原则:
不能让第二种排序接着使用第一种已经排好序的数组。
否则后面的算法面对的是有序数据,而前面的算法面对随机数据,性能对比就失去了意义。
所以每个算法之前都执行:
memcpy(tmp, origin, sizeof(int) * N);恢复完全相同的随机数组。当前测试代码就是按照这一方式依次运行 8 组算法,并使用Check()判断最终是否升序有序。
二、冒泡排序:最直观的交换排序
冒泡排序是最容易理解的一种排序。
核心思想:
相邻两个元素不断比较,如果前面的元素比后面大,就交换位置。
例如:
5 3 8 2第一趟:
5 3 → 交换

3 5 8 2

5 和 8 → 不交换

8 和 2 → 交换

3 5 2 8
第一趟结束以后:
最大值
8已经被“冒”到了最后。
然后第二趟只需要处理前n-1个数据。
代码实现:
void BubbleSort(int* a, int n)
{
	for (int i = 0; i < n - 1; i++)
	{
		int flag = 0;

		for (int j = 0; j < n - 1 - i; j++)
		{
			if (a[j] > a[j + 1])
			{
				Swap(&a[j], &a[j + 1]);
				flag = 1;
			}
		}

		if (flag == 0)
			break;
	}
}当前实现还加入了flag优化:如果某一趟一次交换都没有发生,说明数组已经有序,可以提前退出。这也是当前BubbleSort的实际实现。
复杂度
- 平均、最坏时间复杂度:O(N^2)
- 有序数组最优(flag优化):O(N)
- 空间复杂度:O(1)
冒泡排序最大的意义还是帮助理解排序过程。10 万级随机数据下,O(N^2) 的劣势已经会非常明显。
三、直接插入排序:把新元素插入已经有序的区间
直接插入排序的思路很像整理扑克牌。
假设:
前面的数据已经有序然后每次从后面拿一个新数据,在前面的有序区间寻找合适位置。
例如:
3 5 8 | 4取出:
tmp = 4从后向前比较:
8 > 4
  ↓
8后移

5 > 4
  ↓
5后移

3 < 4
  ↓
 停止
最终:
3 4 5 8代码实现:
void InsertSort(int* a, int n)
{
	for (int i = 1; i < n; i++)
	{
		int tmp = a[i];
		int j = i - 1;

		while (j >= 0 && a[j] > tmp)
		{
			a[j + 1] = a[j];
			j--;
		}

		a[j + 1] = tmp;
	}
}
这与当前工程中的实现一致。
直接插入排序有一个很重要的特性:
数组越接近有序,它越快。
完全随机数组最坏需要大量移动,时间复杂度 (O(N^2));但如果数组本来已经非常接近有序,每个元素可能只移动一两次,性能会非常好。
这个特点正好成为后面希尔排序的基础。
四、希尔排序:先让数组“接近有序”,最后再完成插入排序
希尔排序可以理解为:
直接插入排序的升级版。
直接插入排序的问题在于:如果一个很小的元素出现在数组最后面,它只能一步一步慢慢往前移动。
希尔排序的核心改进是:
不让元素一开始只能移动 1 个位置,而是先允许它按照较大的
gap跨距离移动。
4.1 gap 到底是什么?
这里需要特别区分一个容易混淆的地方:
gap不是每组的数据个数。
gap表示:
同一组相邻元素之间的下标间隔,同时也对应这一趟大致有多少个分组。
例如:
下标:
0 1 2 3 4 5 6 7 8 9

gap = 3
那么分组结果:
第0组:0 3 6 9
第1组:1 4 7
第2组:2 5 8
所以:
分组数量 ≈ gap而每组的数据量大约是:
五、希尔排序为什么会比直接插入快?
希尔排序不是一上来就执行gap = 1,而是先让gap很大,让距离很远的元素提前交换位置。
例如一个很小的数原本在数组尾部:
... ... ... ... 1直接插入排序可能需要向前移动很多次。 而希尔排序在gap = 50的时候,一次移动就能跨越 50 个位置。
然后gap不断缩小:
gap = 25
gap = 12
gap = 6
...
不断进行预排序。
最终执行gap = 1时,整个数组通常已经非常接近有序。
虽然最后一趟本质上还是直接插入排序,但由于数据已经接近有序,元素需要移动的次数会非常少,实际性能可能接近线性扫描。
所以希尔排序的真正思想不是“发明了一种完全新的排序”,而是:
通过前面若干次大跨度预排序,为最后的直接插入排序创造一个非常好的初始状态。
六、第一种实现:三重循环分组处理
当前第一种希尔排序使用gap = n / 2; gap /= 2;生成增量序列。
代码实现:
void ShellSortTriple(int* a, int n)
{
	int gap = n / 2;

	for (; gap > 0; gap /= 2)
	{
		// j遍历每一个分组起点
		for (int j = 0; j < gap; j++)
		{
			// 当前组内部进行插入排序
			for (size_t i = j; i < n - gap; i += gap)
			{
				int end = (int)i;
				int tmp = a[end + gap];

				while (end >= 0)
				{
					if (tmp < a[end])
					{
						a[end + gap] = a[end];
						end -= gap;
					}
					else
					{
						break;
					}
				}

				a[end + gap] = tmp;
			}
		}
	}
}当前源码就是通过j依次完成每一个分组,再进入下一组。因此可以理解成:
先把第0组全部排完
      ↓
   再排第1组
      ↓
   再排第2组
      ↓
……这就是本文所说的三重分组版本。
七、第二种实现:二重循环交叉处理
实际上没有必要真的显式写出“每一个组”。只要i++不断向后遍历,每次仍然按照end -= gap寻找同组前一个元素,就可以让不同分组交叉进行。
代码实现:
void ShellSortDouble(int* a, int n)
{
	int gap = n / 2;

	for (; gap > 0; gap /= 2)
	{
		for (size_t i = 0; i < n - gap; ++i)
		{
			int end = (int)i;
			int tmp = a[end + gap];

			while (end >= 0)
			{
				if (tmp < a[end])
				{
					a[end + gap] = a[end];
					end -= gap;
				}
				else
				{
					break;
				}
			}

			a[end + gap] = tmp;
		}
	}
}当前工程的ShellSortDouble正是这种写法。
三重和二重版本最终完成的是同一个目标:对所有gap分组进行插入排序。区别只是组织代码的方式不同:
| 版本 | 处理方式 |
|---|---|
| 三重循环 | 一组彻底处理完成,再处理下一组 |
| 二重交叉 | i++ 前进,不同组元素交替处理 |
二重写法代码更紧凑,也是实际练习中很值得掌握的一种优化方式。
八、二分增量:gap /= 2
前两种代码使用:
int gap = n / 2;

for (; gap > 0; gap /= 2)如果N = 100000,大致会得到:
50000
25000
12500
6250
3125
...
3
1
它最大的优点是:
逻辑极其简单,而且一定会到达 gap = 1。
最后gap = 1时,整个数组成为一个分组,此时执行的就是一次完整直接插入排序。这一步不可缺少。因为前面的gap > 1只能保证各个间隔分组内部有序,并不能保证整个数组已经完全有序。
九、Knuth 风格增量:gap = gap / 3 + 1
今天在原有二分增量版本基础上,又加入了两种新的希尔排序:
ShellSortTriple_Knuth
ShellSortDouble_Knuth
两个函数都使用:
int gap = n;

while (gap > 1)
{
	gap = gap / 3 + 1;
	...
}
当前三重与二重 Knuth 版本分别实现于源码对应位置。
例如N = 100000时,大致会经历:
33334
11112
3705
1236
413
138
47
16
6
3
2
1相比简单/2,这种序列缩小得更快,需要的 gap 趟数更少,同时不再始终沿着 2 的倍数关系缩小。
9.1 为什么要+1?
当前实现:
gap = gap / 3 + 1;其中+1可以理解成对整数除法结果的一次修正,使 gap 在不断缩小时能够稳定进入:
...
6
3
2
1最终仍然完成gap = 1这一趟完整插入排序。
需要真正记住的是:
无论采用什么 gap 序列,最后都必须保证有一趟 gap=1,否则不能保证数组最终完全有序。
9.2 一个命名上的说明
为了和当前工程函数名保持一致,本文继续称Knuth 增量版本。
不过严格来说,经典 Knuth 增量通常由 (h_{k+1}=3h_k+1) 得到:
1, 4, 13, 40, 121, ...排序时再从大到小使用。
当前代码中的gap = gap / 3 + 1;更准确地说属于一种Knuth 思路下的递减写法 / Knuth 风格增量,和经典序列并不是严格完全相同。
这个区别不影响本文比较当前四组代码,但理论复杂度分析时不能把不同增量序列完全混为一谈。
十、希尔排序的复杂度该怎么看?
希尔排序和冒泡、堆排序有一点很不一样:
它没有一个脱离 gap 序列就能统一给出的简单复杂度。
性能与增量序列、数据分布、实现方式都有很大关系。
二分增量的最坏情况仍然可能达到 O(N^2);而更合理的增量序列通常会明显降低实际移动次数。
有时会用“实际增长趋势大约接近 N^{1.3} 左右”来帮助直观理解某些优秀增量序列下希尔排序的工程表现,但:
这个 O(N^{1.3}) 不应该当成本文
/3+1代码的严格统一理论复杂度。
希尔排序的严格复杂度证明和具体增量序列密切相关,理论分析比较复杂,本篇不展开。
现阶段更值得理解的是整体逻辑:
    gap大
      ↓
组很多、每组数据少
      ↓
  大跨度移动元素

  gap逐渐缩小
      ↓
数组越来越接近有序

    gap=1
      ↓
最终直接插入排序
      ↓
由于已经基本有序,实际移动次数大幅减少
注意:
gap是同组元素的间隔,同时大致决定分组数量;每组元素数约为 (N/gap),并不是“gap 等于每组元素个数”。
十一、堆排序:稳定保持 O(N\log N)
这次性能测试中仍然保留了堆排序。
当前实现先从最后一个非叶子结点开始建大根堆:
for (int i = (n - 2) / 2; i >= 0; i--)
{
	HeapAdjustDown(a, n, i);
}
然后把当前最大值交换到数组末尾,再对剩余区间继续向下调整:
Swap(&a[0], &a[end]);因此升序堆排序的过程就是:
   建大根堆
      ↓
堆顶 = 当前最大值
      ↓
最大值交换到末尾
      ↓
 缩小有效区间
      ↓
 重新向下调整
      ↓
重复- 时间复杂度:O(N\log N)
- 空间复杂度:O(1)
- 最坏情况不会像快速排序那样退化到 O(N^2)
关于堆排序的完整推导,包括为什么升序要建大根堆、为什么降序建小根堆、向下调整、建堆 O(N)、完整堆排序 O(N\log N),前面的文章已经详细讲过,这里不再重复展开。
相关文章:<a href="/#post/2026-08-24-binary-heap">二叉堆与堆排序</a>
十二、双向循环选择排序:一趟同时确定最小值和最大值
这次还加入了一个新的CircleSelectSort,它可以理解为普通选择排序的双向版本。
普通选择排序每一趟通常只找一个最小值,然后放到左边。 双向循环选择排序则在同一趟中同时记录:
int maxi = left;
int mini = left;在[left, right]区间中同时寻找最大值下标maxi和最小值下标mini,然后:
最小值 → left
最大值 → right
一次确定两个位置。
当前完整实现为:
void CircleSelectSort(int* a, int n)
{
	int left = 0;
	int right = n - 1;

	while (left < right)
	{
		int maxi = left;
		int mini = left;

		// 在 [left, right] 区间找最大、最小下标
		for (int i = left; i <= right; i++)
		{
			if (a[i] > a[maxi])
			{
				maxi = i;
			}

			if (a[i] < a[mini])
			{
				mini = i;
			}
		}

		// 最小值放到左侧
		Swap(&a[left], &a[mini]);

		// 修正最大值下标
		if (maxi == left)
		{
			maxi = mini;
		}

		// 最大值放到右侧
		Swap(&a[right], &a[maxi]);

		left++;
		right--;
	}
}十三、这里最容易错:为什么一定要修正maxi?
关键代码:
if (maxi == left)
{
	maxi = mini;
}
这不是多余判断。
假设待排序区间:
9 2 5 1
↑     ↑
max   min
此时:
maxi = left
mini = right
第一步先执行:
Swap(&a[left], &a[mini]);变成:
1 2 5 9原本位于left的最大值9已经被交换到了mini的位置。但是变量maxi仍然记录旧下标left。
如果直接执行:
Swap(&a[right], &a[maxi]);实际上拿到的就不是最大值,而是刚刚换过去的最小值。
因此必须通过判断告诉程序:
最大值已经随着第一次交换移动到了 mini 的位置。
这属于典型的:
数据移动以后,保存的数据下标也可能失效。
如果不修正,部分测试用例就会出现排序错误。
十四、双向选择为什么还是 O(N^2)?
虽然一趟同时处理最小值和最大值,看起来循环趟数大约减少了一半,但每一趟仍然必须完整扫描当前区间: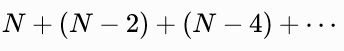
总体数量级仍然是 O(N^2)。
因此:
常数项有所优化,不改变时间复杂度阶数。
这也很好地说明:“循环少一半”并不意味着“O(N²) → O(N)”,大 O 复杂度关注的是数据规模增长后的最高阶趋势。
十五、各排序算法复杂度横向对比
结合当前实现,可以整理成下表:
| 排序算法 | 最好时间 | 平均/常见 | 最坏时间 | 额外空间 | 稳定性 |
|---|---|---|---|---|---|
| 冒泡排序 | O(N) | O(N^2) | O(N^2) | O(1) | 稳定 |
| 直接插入 | O(N) | O(N^2) | O(N^2) | O(1) | 稳定 |
| 双向循环选择 | O(N^2) | O(N^2) | O(N^2) | O(1) | 不稳定 |
| 希尔排序 | 与增量有关 | 与增量有关 | 与增量有关 | O(1) | 不稳定 |
| 堆排序 | O(N\log N) | O(N\log N) | O(N\log N) | O(1) | 不稳定 |
从 10 万级随机数据的预期表现来看,一般可以看到三个比较明显的层次:
冒泡 / 插入 / 双向选择
        ↓
      O(N²)

     希尔排序
        ↓
明显优于基础 O(N²) 排序

      堆排序
        ↓
O(NlogN),增长趋势稳定
不过实际秒数一定受 CPU、编译器、Debug / Release、编译优化等级、随机数据分布、操作系统负载影响,所以不能把某一次运行时间当成算法的绝对速度。
十六、性能测试代码
当前sort_test.c对 8 组实现都采用相同方式:
memcpy(tmp, origin, sizeof(int) * N);

clock_t start = clock();

Sort(tmp, N);

clock_t end = clock();

Check(tmp, N);
其中 Knuth 两组以及新增双向循环选择已经加入最后三组测试。
完整测试结构:
#include "sort.h"

int main(void)
{
	srand((unsigned int)time(NULL));

	const int N = 100000;
	printf("测试数据规模:%d\n\n", N);

	int* origin = GenArray(N);
	int* tmp = (int*)malloc(sizeof(int) * N);

	// 1.冒泡排序
	memcpy(tmp, origin, sizeof(int) * N);
	clock_t s1 = clock();
	BubbleSort(tmp, N);
	clock_t e1 = clock();
	printf("BubbleSort 冒泡排序: %.3fs, %s\n",
		(double)(e1 - s1) / CLOCKS_PER_SEC,
		Check(tmp, N) ? "ok" : "err");

	// 2.插入排序
	memcpy(tmp, origin, sizeof(int) * N);
	clock_t s2 = clock();
	InsertSort(tmp, N);
	clock_t e2 = clock();
	printf("InsertSort 插入排序: %.3fs, %s\n",
		(double)(e2 - s2) / CLOCKS_PER_SEC,
		Check(tmp, N) ? "ok" : "err");

	// 3.堆排序
	memcpy(tmp, origin, sizeof(int) * N);
	clock_t s3 = clock();
	HeapSort(tmp, N);
	clock_t e3 = clock();
	printf("HeapSort   堆排序:   %.3fs, %s\n",
		(double)(e3 - s3) / CLOCKS_PER_SEC,
		Check(tmp, N) ? "ok" : "err");

	// 4.希尔排序 三重循环
	memcpy(tmp, origin, sizeof(int) * N);
	clock_t s4 = clock();
	ShellSortTriple(tmp, N);
	clock_t e4 = clock();
	printf("ShellSortTriple(三重分组): %.3fs, %s\n",
		(double)(e4 - s4) / CLOCKS_PER_SEC,
		Check(tmp, N) ? "ok" : "err");

	// 5.希尔排序 二重循环交叉版本
	memcpy(tmp, origin, sizeof(int) * N);
	clock_t s5 = clock();
	ShellSortDouble(tmp, N);
	clock_t e5 = clock();
	printf("ShellSortDouble(二重交叉): %.3fs, %s\n",
		(double)(e5 - s5) / CLOCKS_PER_SEC,
		Check(tmp, N) ? "ok" : "err");

	// 6.希尔排序 三重分组 Knuth
	memcpy(tmp, origin, sizeof(int) * N);
	clock_t s6 = clock();
	ShellSortTriple_Knuth(tmp, N);
	clock_t e6 = clock();
	printf("ShellTriple_Knuth(三重Knuth): %.3fs, %s\n",
		(double)(e6 - s6) / CLOCKS_PER_SEC,
		Check(tmp, N) ? "ok" : "err");

	// 7.希尔排序 二重交叉 Knuth
	memcpy(tmp, origin, sizeof(int) * N);
	clock_t s7 = clock();
	ShellSortDouble_Knuth(tmp, N);
	clock_t e7 = clock();
	printf("ShellDouble_Knuth(二重Knuth): %.3fs, %s\n",
		(double)(e7 - s7) / CLOCKS_PER_SEC,
		Check(tmp, N) ? "ok" : "err");

	// 8.双向循环选择排序
	memcpy(tmp, origin, sizeof(int) * N);
	clock_t s8 = clock();
	CircleSelectSort(tmp, N);
	clock_t e8 = clock();
	printf("CircleSelectSort 双向循环选择排序: %.3fs, %s\n",
		(double)(e8 - s8) / CLOCKS_PER_SEC,
		Check(tmp, N) ? "ok" : "err");

	free(tmp);
	free(origin);

	return 0;
}十七、为什么还需要Check()?
只比较时间是不够的。一种算法即使 0.001 秒结束,如果排序结果是错的,这个速度没有任何意义。
所以每个算法执行结束以后都调用:
Check(tmp, N)逐个检查:
a[i] <= a[i + 1]如果全部成立返回ok,否则返回err。
当前Check()正是通过一次线性扫描完成升序校验。所以每一行测试结果应该同时看两个信息:
运行时间 + ok/err十八、运行方式
GCC 下直接编译:
gcc sort.c sort_test.c -o sort_test
./sort_test
程序输出格式类似:
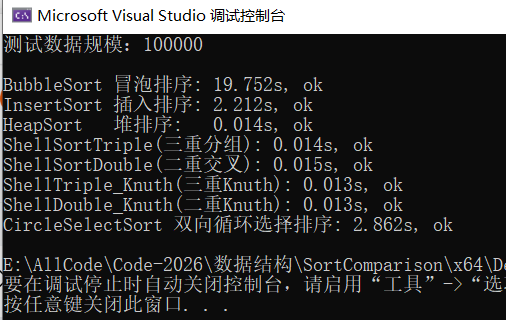
测试数据规模:100000

BubbleSort 冒泡排序:                  shturl. s, ok
InsertSort 插入排序:                  shturl. s, ok
HeapSort 堆排序:                        shtur s, ok
ShellSortTriple(三重分组):              shtur s, ok
ShellSortDouble(二重交叉):              shtur s, ok
ShellTriple_Knuth(三重Knuth):           shtur s, ok
ShellDouble_Knuth(二重Knuth):           shtur s, ok
CircleSelectSort 双向循环选择排序:      shturl. s, ok
这里提示:
真实运行时间应该以自己的机器实测为准。
更重要的是观察不同复杂度算法之间的数量级差异。
十九、这一轮测试真正想比较什么?
这次测试并不只是为了得到一张“谁最快、谁最慢”的排行榜。
更值得观察的是算法思想如何一步步变化。
最基础的冒泡排序、双向选择排序、直接插入排序,面对随机数据,本质上都逃不开大量的 O(N^2) 比较或移动。
希尔排序开始引入预排序:先通过大gap让数据快速接近目标位置,再逐渐缩小gap,最后利用直接插入排序对近乎有序的数据收尾。
到了堆排序,则从线性表内部移动思维切换到利用完全二叉树维护极值,最终把复杂度稳定降低到 O(N\log N)。
这几种算法放在同一个工程里对比以后,会比单独记“冒泡 O(N²)、堆排序 O(NlogN)”更加直观。
二十、本篇几个重点易错点
- 希尔排序最后必须有
gap = 1否则只能保证多个子序列有序,不能保证整个数组有序。 gap不是每组元素个数它是同组元素之间的下标间隔,同时大致对应分组数量,每组元素个数约为 。
- 三重和二重版本算法思想相同区别只是“一组一组完成”还是“不同分组交叉处理”。
/3+1的 只能作为实际性能的粗略理解希尔排序严格复杂度与增量序列有关,不能简单给所有实现统一套一个 O(N^{1.3})。
CircleSelectSort必须修正maxi`if (maxi == left)
{ maxi = mini; }因为第一次交换可能已经把最大值从left移到了mini`,继续使用旧下标会找错最大值。
- 性能测试必须使用相同输入所以每次都
memcpy(tmp, origin, sizeof(int) * N);,而不是让后一个算法继续排序前一个算法已经处理过的数据。
写在最后
这一篇从冒泡、直接插入到双向循环选择,首先能看到最基础的 O(N^2) 排序是怎样一步步移动数据的;再到希尔排序,通过gap分组预排序,把“一个元素只能慢慢挪”的直接插入排序改造成了能够大跨度移动的版本。
今天增加的两种/3+1增量版本,也进一步说明:
希尔排序的核心不只是插入排序本身,增量序列同样直接影响实际效率。
而CircleSelectSort中:
if (maxi == left)
	maxi = mini;
又是一个很典型的指针 / 下标思维问题:数据交换以后,不只是数值变了,之前记录的位置也可能已经失效。
把这些算法统一放到 10 万随机数据中测试后,也能够更直接地看到复杂度带来的差距:O(N^2) 和 O(N\log N) 在数据规模小时可能感觉不明显,但随着 (N) 增长,差距会越来越夸张。
后续排序专题还可以继续加入快速排序、归并排序、计数排序等算法,再把不同排序方法放在统一测试框架下做更完整的横向比较。