栈和队列专题(三):LeetCode 622. 设计循环队列|数组环形复用 + front/rear 边界详解
本文详细讲解了循环队列的设计与实现,重点分析了如何利用数组实现环形结构以避免空间浪费。文章首先通过示例说明普通数组队列的"假溢出"问题,然后提出循环队列的解决方案。核心内容包括:1. 采用牺牲一个存储位置的方案区分队列空满状态;2. 明确front和rear指针的语义(front指向队首元素,rear指向下一个可插入位置);3. 使用取模运算实现下标的循环移动。文章完整实现了LeetCode 622题要求的全部接口,并分析了各种边界情况,特别是队尾元素的获取方法。最后对比了数组实现与链式
写在前面
前两篇分别完成了栈、队列的基础实现,以及 LeetCode 225「用队列实现栈」。到了这一篇,开始真正进入队列本身的经典实现问题:
如果底层使用数组,怎样避免队首出队之后前面的空间越来越浪费?
这就是循环队列要解决的核心问题。
普通数组队列如果只让rear一直向后移动,即使前面的元素已经出队,只要rear到达数组末尾,看起来就无法继续插入了。
比如容量为 5 的顺序队列:
下标: 0    1    2    3    4

初始入队5个元素:
[ 10 ][ 20 ][ 30 ][ 40 ][ 50 ]
  ↑                        ↑
front                     rear

连续出队3个元素后:
[  × ][  × ][  × ][ 40 ][ 50 ]
                     ↑     ↑
                   front  rear
前面明明已经空出了 3 个位置,却因为 rear 走到了数组末尾就判定“满了”,无法继续插入新元素。这种“物理空间有空位,但逻辑上认为溢出”的现象,就叫做假溢出。
循环队列的核心思路非常直白:
让数组下标走到末尾以后重新回到开头,把已经释放的前置空间继续利用起来,把线性数组“掰成一个环”。
这道题真正值得吃透的不是代码量,而是三个本质问题:
- 为什么实际要申请
k+1个位置? front和rear分别代表什么?- 为什么所有下标移动都要取模?
一、题目要求
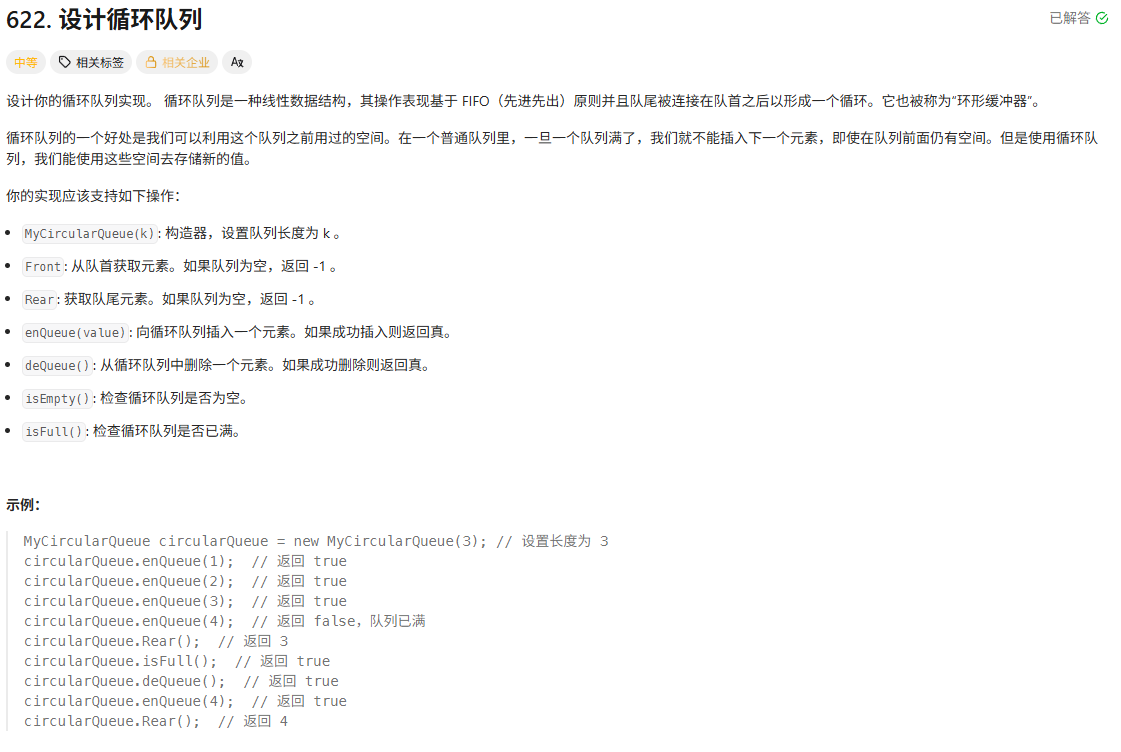
LeetCode 622 要求设计一个固定容量的循环队列,支持以下接口:
| 接口 | 功能 |
|---|---|
| MyCircularQueue(k) | 创建最大有效容量为 k 的循环队列 |
| enQueue(value) | 向队尾插入元素,成功返回 true |
| deQueue() | 删除队首元素,成功返回 true |
| Front() | 获取队首元素,队空返回 -1 |
| Rear() | 获取队尾元素,队空返回 -1 |
| isEmpty() | 判断队列是否为空 |
| isFull() | 判断队列是否已满 |
队列依然遵循 FIFO(先进先出)原则,区别只是底层数组被逻辑上首尾相连地使用。
二、核心方案:牺牲一个位置区分队空与队满
在正式讲标准写法之前,先提一种最直观的 “笨办法”:不用取模,全靠if手动判断边界。
比如数组长度是 4,rear向后移动时:
- 如果
rear还没到末尾,就rear++ - 如果
rear已经是最后一个下标了,就让它直接回到 0
判满也是同理,分情况写:
- 正常情况:
rear + 1 == front就满了 - 边界情况:
rear已经在 0,而front在数组最后一位,也算满了
同样,取队尾、移动 front 也都要写两套逻辑处理边界。
这种写法思路最直白,对着特殊情况一条条补if就行;但缺点也很明显:每个操作都要写分支判断,代码冗余、容易漏边界,本质就是把 “环形回绕” 的逻辑拆成了多个 if 手动处理。
而后面要讲的取模写法,其实就是用一个数学公式把这些分支统一了起来。
循环队列有一个绕不开的经典矛盾: 如果只靠front和rear两个下标,当front == rear时,我们无法区分当前队列是空还是满。
举个例子:
- 队空时:所有元素都出队了,front 和 rear 最终会重合
- 队满时:所有位置都存满了,rear 绕一圈回来也会和 front 重合
单靠两个下标,两种状态共用同一个表达式,必然产生歧义。
解决这个问题有两种主流思路:
- 额外增加一个
size变量,记录当前元素个数,用size==0判空、size==k判满 - 主动牺牲一个存储位置,多开一格空间,用“rear 再走一步就撞上 front”表示队满
本篇采用最经典、也最适合理解环形下标的第二种方案:
用户要求容量为 k,数组实际开辟
k + 1个位置,其中最多只存 k 个有效元素,多出来的 1 格只用来区分空满状态,不存放有效数据。
由此可以得到两个非常清晰的判断规则:
- 队空:
front == rear - 队满:
(rear + 1) % (k + 1) == front
没有歧义,也不需要额外维护计数变量。
三、结构体设计:先固定 front 和 rear 的语义
我们统一语义:
typedef struct {
    int* arr;   // 底层动态数组
    int front;  // 当前队首元素的下标
    int rear;   // 下一个可插入位置的下标(不是队尾元素下标)
    int k;      // 用户指定的最大有效容量
} MyCircularQueue;front:永远指向当前第一个有效元素rear:永远指向下一个可以插入新元素的空位
举个直观例子:
数组内容:[ 10 ][ 20 ][ 30 ][  ][  ]
下标:      0     1     2    3    4
            ↑          ↑
          front       rear
此时:
- 队首元素 =
arr[front]= 10 - 队尾元素是 30,位于
rear的前一个位置 - 下一个新元素应该放在下标 3,也就是
rear指向的位置
这个语义一旦固定,后面所有公式都可以顺着推导出来,不需要死记硬背。
四、为什么一定要取模?
取模运算%是实现“环形”的核心手段。
物理上的数组是线性的,下标只能从 0 到 n-1 单向增加;但逻辑上我们要让它首尾相连,下标走到末尾后能自动跳回开头。
假设数组实际长度是 4(k=3,k+1=4),我们希望下标按这个规律循环:
0 → 1 → 2 → 3 → 0 → 1 → 2 ...这个效果刚好可以通过(下标 + 1) % 数组长度实现。
比如当前 rear = 3,向后移动一位:
rear = (3 + 1) % 4;
// 计算结果:rear = 0
下标就从数组末尾跳回了开头,完成了一次“回绕”。
所以取模不是炫技,它的作用非常纯粹:
用数学方式把线性数组的下标,映射成逻辑上的环形队列。
五、六个核心操作逐个拆解
5.1 初始化
MyCircularQueue* myCircularQueueCreate(int k) {
    MyCircularQueue* obj = (MyCircularQueue*)malloc(sizeof(MyCircularQueue));
    obj->k = k;
    obj->arr = (int*)malloc(sizeof(int) * (obj->k + 1));
    obj->front = 0;
    obj->rear = 0;
    return obj;
}
初始化时 front 和 rear 都为 0,满足front == rear,表示队列为空。 注意数组开辟的是k+1个空间,而不是 k 个。
5.2 判断队空
bool myCircularQueueIsEmpty(MyCircularQueue* obj) {
    return obj->front == obj->rear;
}
我们已经把“下标重合”专门定义为空状态,判空直接判断即可,时间复杂度 O(1)。
5.3 判断队满
bool myCircularQueueIsFull(MyQueue* obj) {
    return (obj->rear + 1) % (obj->k + 1) == obj->front;
}
可以理解为:如果 rear 再往前走一步就会碰到 front,说明再插入就会破坏“留一格”的规则,队列已经满了。 取模是为了处理 rear 在数组末尾的边界情况。
5.4 入队
bool myCircularQueueEnQueue(MyCircularQueue* obj, int value) {
    if(myCircularQueueIsFull(obj)){
        return false;
    }
    obj->arr[obj->rear] = value;
    obj->rear = (obj->rear + 1) % (obj->k + 1);
    return true;
}
因为 rear 本身就是“下一个可插入位置”,所以步骤一定是:
- 把新元素写入 rear 指向的空位
- rear 向后移动一位,继续指向下一个空位
顺序不能搞反,这完全由我们定义的 rear 语义决定。
5.5 出队
bool myCircularQueueDeQueue(MyCircularQueue* obj) {
   if(myCircularQueueIsEmpty(obj)){
        return false;
    }
    obj->front = (obj->front + 1) % (obj->k + 1);
    return true;
}
出队不需要真的清空原队首的数据,只需要把 front 向后移动一位,让原来的位置退出有效区间即可。 和顺序栈 pop 只移动 top 不清空数组是同一个思想:
数据是否有效,由边界指针决定,而不是看内存里的旧值有没有被抹掉。
5.6 获取队首
int myCircularQueueFront(MyCircularQueue* obj) {
    if(myCircularQueueIsEmpty(obj)){
        return -1;
    }
    return obj->arr[obj->front];
}
front 本身就指向第一个有效元素,直接返回即可。
六、Rear 为什么比 Front 多一步计算?
这是本题最容易写错的地方,但顺着语义推导其实非常自然。
因为 rear 指向的是“下一个空位”,不是队尾元素,所以真正的队尾一定在 rear 的前一个位置。
正常情况下写rear - 1没问题,但如果 rear 刚好在 0 号位置,rear - 1就变成了 -1,数组没有负下标。
所以要先加上一整个数组长度,保证数值为正,再取模回绕:
(rear - 1 + 数组长度) % 数组长度完整代码:
int myCircularQueueRear(MyCircularQueue* obj) {
    if(myCircularQueueIsEmpty(obj)){
        return -1;
    }
    int pos = (obj->rear - 1 + (obj->k + 1)) % (obj->k + 1);
    return obj->arr[pos];
}
举个边界例子验证:
k = 3,数组长度 = 4
rear = 0
代入计算:
(0 - 1 + 4) % 4 = 3 % 4 = 3说明队尾元素在下标 3 的位置,正好完成了跨边界的回绕。
七、完整 LeetCode AC 代码
#include <stdlib.h>
#include <stdbool.h>

typedef struct {
    int* arr;
    int front;
    int rear;
    int k;
} MyCircularQueue;

MyCircularQueue* myCircularQueueCreate(int k) {
    MyCircularQueue* obj = (MyCircularQueue*)malloc(sizeof(MyCircularQueue));
    obj->k = k;
    obj->arr = (int*)malloc(sizeof(int) * (obj->k + 1));
    obj->front = 0;
    obj->rear = 0;
    return obj;
}

bool myCircularQueueIsEmpty(MyCircularQueue* obj) {
    return obj->front == obj->rear;
}

bool myCircularQueueIsFull(MyCircularQueue* obj) {
    return (obj->rear + 1) % (obj->k + 1) == obj->front;
}

bool myCircularQueueEnQueue(MyCircularQueue* obj, int value) {
    if(myCircularQueueIsFull(obj)){
        return false;
    }
    obj->arr[obj->rear] = value;
    obj->rear = (obj->rear + 1) % (obj->k + 1);
    return true;
}

bool myCircularQueueDeQueue(MyCircularQueue* obj) {
   if(myCircularQueueIsEmpty(obj)){
        return false;
    }
    obj->front = (obj->front + 1) % (obj->k + 1);
    return true;
}

int myCircularQueueFront(MyCircularQueue* obj) {
    if(myCircularQueueIsEmpty(obj)){
        return -1;
    }
    return obj->arr[obj->front];
}

int myCircularQueueRear(MyCircularQueue* obj) {
    if(myCircularQueueIsEmpty(obj)){
        return -1;
    }
    int pos = (obj->rear - 1 + (obj->k + 1)) % (obj->k + 1);
    return obj->arr[pos];
}

void myCircularQueueFree(MyCircularQueue* obj) {
    free(obj->arr);
    free(obj);
}
八、用一个完整例子看懂“循环”
我们用 k=3(实际数组长度 4)完整走一遍流程,直观感受环形效果。
初始状态:
[  ][  ][  ][  ]
  ↑
front
rear
依次入队 10、20、30:
[10][20][30][  ]
  ↑           ↑
front        rear
此时有效元素已经有 3 个,虽然还有一个空位,但必须保留用于区分空满,因此队列已满。
执行一次出队:
[10][20][30][  ]
      ↑       ↑
    front    rear
10 被逻辑删除,front 后移一位。
再入队 40: 元素写入 rear 指向的下标 3:
[10][20][30][40]
      ↑
    front
rear 向后移动一位,通过取模回到 0:
rear
  ↓
[10][20][30][40]
      ↑
front此时逻辑上的有效队列是20 → 30 → 40,虽然物理数组里 40 在 20 前面,但从环形顺序看完全连续。 这就是循环队列最核心的魅力:物理线性,逻辑环形。
九、复杂度分析
这套实现没有任何遍历操作,所有接口都是常数时间:
| 接口 | 时间复杂度 |
|---|---|
| enQueue | O(1) |
| deQueue | O(1) |
| Front | O(1) |
| Rear | O(1) |
| isEmpty | O(1) |
| isFull | O(1) |
空间复杂度为 O(k),需要申请与容量成正比的数组。
相比链式队列,它没有额外的指针开销,不需要频繁申请释放节点,连续内存对 CPU 缓存也更友好;代价是容量固定,无法动态扩容。两种实现没有绝对优劣,只是用不同的存储结构换取不同的特性。
十、拓展对比:链式实现队列的思路与局限
讲完数组方案,自然会有一个疑问:队列本来就可以用链表实现,那用单链表、循环链表、双向链表来做这道题行不行?
答案是都能实现队列功能,但都不是本题最贴合考点、最省事的方案,这里简单梳理一下。
10.1 普通单链表实现队列
思路很直接:维护head(队首)、tail(队尾)两个指针,再加一个size计数控制最大容量 k。
- 入队:尾节点后插入新节点,tail 后移
- 出队:删除头节点,head 后移
- 取队首/队尾:直接访问 head/tail 节点的值
它的优点是天然动态扩容,不存在假溢出,头尾操作都是 O(1),取队尾也很方便。 但麻烦的点也很明显:
- 边界处理繁琐:空队列、仅一个节点时,头删后 tail 指针要同步置空,很容易漏写
- 每个节点带
next指针,空间开销比数组大 - 节点内存不连续,CPU 缓存命中率低
- 最关键的是:它只是普通链式队列,完全没有体现“循环复用空间”的核心,和 622“循环队列”的考点关联度很低
10.2 循环单链表
也就是让尾节点的next指向头节点,形成一个环,甚至可以只存一个tail指针,用tail->next表示队首。
名字里虽然带“循环”,但对于只操作两端的队列来说,它并没有带来实质优势,反而让空队列、单节点的边界判断更绕,属于形式上循环,实用性不如普通单链表+双指针。
10.3 双向链表
每个节点同时带prev和next指针,头尾各一个指针。 优点是两端插入删除都绝对 O(1),边界处理更顺手;但缺点也很突出:
- 实现最繁琐,每个节点多一个指针,空间开销最大
- 对于队列这种“尾部入、头部出”的结构,单链表已经能做到 O(1),双链表属于能力过剩,增加了不必要的复杂度
小结
链式实现更适合容量不确定、动态增减的通用队列场景;但对于 622 这种固定容量、核心考察“环形空间复用思想”的题目,数组循环队列才是最贴合题意、最能体现考点的标准解法。
十一、再拓展:能不能用两个栈实现这道题?
学过“用队列实现栈”之后,很多人会自然反问:能不能反过来用两个栈实现队列?
答案是:完全可以实现队列语义,但它同样不是 622 这道题最自然、最贴合考点的方案。
11.1 双栈方案的基本思路
用两个栈分工协作:
inStack:专门接收入队,所有 push 直接压入此栈outStack:专门处理出队、取队头;为空时把 inStack 全部元素倒入,栈顶即为队头
两次 LIFO 叠加就能得到 FIFO 的效果,这个方案没有取模运算,工程中还可以直接复用已有的栈模块,代码复用性很强。
11.2 为什么它不适合 622 这道题?
首先要明确:双栈可以实现完整的队列功能,并不是“做不到”。 但 622 有一个非常关键的接口——Rear()获取队尾元素,这恰恰是纯栈接口的天然短板。
- 元素还在 inStack 时,队尾就是栈顶,O(1) 可取
- 元素全部迁移到 outStack 后,逻辑队尾跑到了outStack 的栈底。而标准栈只能访问栈顶,无法直接读取栈底
当然,我们可以通过额外维护一个backVal缓存变量,把 Rear 也优化到 O(1)。但这样一来,实现重点就从“双栈模拟 FIFO”变成了“靠额外变量补全接口”,偏离了 622 本身的考察核心。
622 题名叫“设计循环队列”,它真正想考察的是:
- 数组空间如何循环复用
- front/rear 如何回绕
- 空满状态如何区分
- 取模如何构造环形下标
这些点恰恰是数组循环队列最直接、最贴切的内容。
11.3 那双栈方案什么时候最香?
如果题目不需要获取队尾,只要求入队、出队、取队头、判空,双栈方案就会变得非常优雅。 它的迁移逻辑有很巧妙的优化点:只有 outStack 为空时才整体迁移,每个元素最多被搬运一次,能做到摊还 O(1)。
而这正好就是下一道经典题的内容。
十二、本地工程化拆分
代码仓库:
数据结构/8.19 LeetCode 622. 设计循环队列 · Luminous/Code_2026 - 码云 - 开源中国
LeetCode 提交时单文件即可,本地我依然按模块化习惯拆分:
LeetCode622_CircularQueue/
├── circular_queue.h
├── Arr_circular_queue.c
└── main.ccircular_queue.h:结构体定义与接口声明Arr_circular_queue.c:环形数组核心实现main.c:本地测试用例
特别建议重点测试 rear 从数组末尾跳回 0 的边界场景,这才是真正验证“循环”有没有写对的关键。
十三、写在最后
LeetCode 622 代码不长,但它是一道非常适合锻炼“下标设计思维”的题。
真正该记住的从来不是(rear + 1) % (k + 1)这个公式,而是先把每个变量的语义定义清楚:
- front = 当前队首元素位置
- rear = 下一个可插入位置
变量含义定死之后,判空、判满、入队、出队、取队尾的公式,全都是自然推导的结果。
这也是学习数据结构很重要的一个思路:
先定义清楚“每个变量代表什么”,再去写代码;而不是先写代码,再去猜变量的含义。
下篇预告
上一题我们用两个队列模拟了一个栈,下一篇我们完全反过来:用两个栈模拟一个队列。
栈和队列专题(四):LeetCode 232. 用栈实现队列,我们会拆解双栈的分工逻辑、元素迁移时机,以及为什么单次 O(n) 的搬运,最终能做到摊还 O(1)。