数据结构|栈和队列(二):C 语言链式队列完整实现|结构设计 + 代码 + 复盘 + size 成员深度解析
本文详细介绍了链式队列的实现原理与优化技巧。通过对比顺序表实现队列的缺陷,阐明单链表+尾指针方案的高效性(入队/出队O(1))。重点解析了front/rear双指针与size成员的设计价值,后者可将长度查询从O(N)优化至O(1)。文章提供模块化代码实现,包含初始化、入队、出队等核心操作,特别强调边界处理(空队列和单节点场景)。附有典型错误案例复盘和完整测试用例,测试覆盖队列各种状态转换。所有代码已开源,采用头文件与实现文件分离的规范写法,可直接编译调试。
前言
承接上一篇顺序栈的实现,本篇完成「先进先出」的链式队列手写。 全文围绕三个核心问题展开:为什么队列优先选单链表实现、front+rear双指针的设计意义、size成员的价值,同时附上完整可运行代码与真实实现过程中的踩坑复盘。
本文全部代码已托管至 Gitee,代码采用头文件与实现文件分离的模块化写法,测试用例覆盖空队列、单节点、多次入出队等全部边界场景,可直接拉取本地编译调试。
Gitee 仓库地址:
数据结构/8.17 队列练习Queue · Luminous/Code_2026 - 码云 - 开源中国
一、队列基础:先进先出的线性表
队列是操作受限的线性表,仅允许在队尾(rear)插入、队头(front)删除,遵循FIFO(First In First Out,先进先出)规则。
典型应用场景:
- 二叉树层序遍历、图的广度优先搜索(BFS)
- 操作系统任务调度、请求排队
- 生产者消费者模型、消息缓冲区
二、实现选型:为什么队列更适合用单链表?
实现队列有「顺序表」和「链表」两条路线,选择单链表并非习惯,而是由队列的操作特性决定的。
2.1 顺序表实现队列的天然缺陷
如果用数组实现队列,会直接撞上「头删低效」的问题:
- 普通数组:队头删除需要整体搬移后续元素,时间复杂度O(N),效率极低
- 循环队列:通过双下标规避搬移,但又引入新问题——容量固定无法动态扩容、「队空/队满」边界判断繁琐、存在空间浪费
本质上,顺序表是在弥补「头删」的天生短板,需要额外处理大量环形逻辑。
2.2 单链表的天然适配性
单链表的特性刚好匹配队列的操作模式:
- 队头删除 = 链表头删,天然O(1)
- 队尾插入 = 链表尾插,只要增加一个尾指针
rear,也能做到O(1) - 动态申请节点,无固定容量上限,元素数量不确定的场景更友好
2.3 为什么不用双向链表?
双向链表虽然自带尾指针,但每个节点多一个prev指针,会额外占用内存。队列仅涉及头删、尾插,完全不需要向前遍历,双向链表属于冗余设计。
所以,单链表 + 尾指针,是实现队列性价比最高的方案。
三、链式队列的结构设计
采用「节点结构体 + 队列管理结构体」的分层设计,职责分离更清晰。
3.1 节点结构体
typedef struct QueueNode {
	QDataType data;       // 存储数据
	struct QueueNode* next; // 指向后继节点
} QueueNode;
与普通单链表节点完全一致,负责存储数据与维系链表关系。
3.2 队列管理结构体
typedef struct Queue {
	QueueNode* front; // 队头指针,指向第一个节点
	QueueNode* rear;  // 队尾指针,指向最后一个节点
	int size;         // 记录有效元素个数
} Queue;
三个成员共同描述队列的完整状态:
front:服务队头出队、取队头元素rear:服务队尾入队、取队尾元素,将尾插从 O(N) 优化到 O(1)size:记录元素总数,是性价比极高的可选优化
四、深度解析:size 成员的设计价值
size不是链式队列的必需成员,但属于「极小成本换极大收益」的经典设计,核心价值有三点:
- 长度查询从 O(N) 降为 O(1)无
size时,求队列长度必须从头遍历链表;加入size后,入队+1、出队-1,查询直接返回数值,频繁查询长度的场景性能提升显著。 - 辅助校验队列状态
size是独立于指针的第二维度状态。正常情况下,size == 0必然对应front == NULL && rear == NULL。调试时如果两者不一致,可以快速定位出入队/出队/销毁操作的状态维护错误。 - 空间成本极低仅占用一个
int的内存(通常4字节),换来常数级的查询效率与更清晰的代码语义。
注意:
size并不天然比指针判空更安全。如果代码本身维护错误,size同样会失真。核心是始终维护队列的不变量:空队列时front == NULL && rear == NULL && size == 0。
五、完整代码实现
采用模块化拆分:Queue.h声明接口,Queue.c实现逻辑,test.c测试验证。
5.1 Queue.h 头文件
#pragma once
#include<stdio.h>
#include<stdlib.h>
#include<assert.h>

typedef int QDataType;

// 队列节点
typedef struct QueueNode {
	QDataType data;
	struct QueueNode* next;
} QueueNode;

// 队列管理结构体
typedef struct Queue {
	QueueNode* front;
	QueueNode* rear;
	int size;
} Queue;

void QueueInit(Queue* q);          // 初始化
void QueuePush(Queue* q, QDataType data); // 队尾入队
void QueuePop(Queue* q);           // 队头出队
QDataType QueueFront(Queue* q);    // 获取队头元素
QDataType QueueBack(Queue* q);     // 获取队尾元素
int QueueSize(Queue* q);           // 获取元素个数
int QueueEmpty(Queue* q);          // 判空
void QueueDestroy(Queue* q);       // 销毁队列
5.2 Queue.c 实现文件
#include"Queue.h"

// 初始化队列
void QueueInit(Queue* q)
{
	assert(q);
	q->front = NULL;
	q->rear = NULL;
	q->size = 0;
}

// 队尾入队列
void QueuePush(Queue* q, QDataType data)
{
	assert(q);
	QueueNode* Newnode = (QueueNode*)malloc(sizeof(QueueNode));
	if (Newnode == NULL)
	{
		printf("malloc fail\n");
		return;
	}
	// 先初始化节点,再接入链表
	Newnode->next = NULL;
	Newnode->data = data;

	if (q->front == NULL)
	{
		// 空队列首次入队:头尾同时指向新节点
		q->front = Newnode;
		q->rear = Newnode;
	}
	else
	{
		// 非空队列:尾插后更新尾指针
		q->rear->next = Newnode;
		q->rear = Newnode;
	}
	q->size++;
}

// 队头出队列
void QueuePop(Queue* q)
{
	assert(q && q->front);
	if (q->front != q->rear)
	{
		// 多个节点:头指针后移,释放旧头
		QueueNode* node = q->front;
		q->front = q->front->next;
		free(node);
	}
	else
	{
		// 仅剩最后一个节点:释放后双指针同时置空
		free(q->front);
		q->front = NULL;
		q->rear = NULL;
	}
	q->size--;
}

// 获取队头元素
QDataType QueueFront(Queue* q)
{
	assert(q && q->front);
	return q->front->data;
}

// 获取队尾元素
QDataType QueueBack(Queue* q)
{
	assert(q && q->rear);
	return q->rear->data;
}

// 获取有效元素个数
int QueueSize(Queue* q)
{
	assert(q);
	return q->size;
}

// 判空:空返回1,非空返回0
int QueueEmpty(Queue* q)
{
	assert(q);
	return q->size == 0 ? 1 : 0;
}

// 销毁队列
void QueueDestroy(Queue* q)
{
	assert(q);
	while (q->front)
	{
		QueueNode* node = q->front;
		q->front = q->front->next;
		free(node);
	}
	// 释放完节点,重置所有状态
	q->rear = NULL;
	q->size = 0;
}
5.3 两个核心边界处理
链式队列的逻辑难点不在常规操作,而在两个边界状态:
- 首次入队:空队列插入第一个节点时,该节点既是队头也是队尾,必须同时给
front和rear赋值。 - 删除最后一个节点:当
front == rear时,释放节点后必须将双指针同时置空,否则rear会变成野指针。
六、实现踩坑复盘
以下是手写过程中真实遇到的典型问题,大多不属于「算法不会」,而是指针状态维护不完整。
| 序号 | 问题描述 | 后果 | 修正方案 |
|---|---|---|---|
| 1 | 初始化重复赋值 front,漏写 rear | rear 为随机脏值,首次入队访问野内存 | 双指针必须同步初始化为 NULL |
| 2 | malloc 后先访问节点成员,再判空 | 申请失败时直接对空指针解引用,程序崩溃 | 先判空,确认成功后再使用节点 |
| 3 | 新节点未显式置 next = NULL | 尾节点 next 为垃圾值,遍历/销毁时越界 | 每个新节点创建后必须手动置空 next |
| 4 | 删除最后一个节点只置空 front | rear 成为野指针,指向已释放内存 | 尾节点删除后,front、rear 同时置 NULL |
| 5 | 销毁队列只释放节点,不重置状态 | 销毁后 rear 野指针、size 残留旧值 | 销毁后手动重置 rear 与 size,恢复空队列状态 |
| 6 | 局部临时指针 free 后置 NULL | 冗余代码,无实际作用(局部变量函数结束即销毁) | 仅结构体成员指针 free 后需要置空 |
七、测试验证
7.1 测试代码 test.c
覆盖空队列、多次入出队、清空后重入队等全边界场景:
#include "Queue.h"
#include <stdio.h>

void PrintQueue(Queue* q)
{
    if (QueueEmpty(q))
    {
        printf("队列:[空]\n");
        return;
    }
    QueueNode* cur = q->front;
    printf("队列:");
    while (cur != NULL)
    {
        printf("%d ", cur->data);
        cur = cur->next;
    }
    printf(" | 头=%d 尾=%d size=%d\n",
           QueueFront(q), QueueBack(q), QueueSize(q));
}

int main(void)
{
    Queue q;
    QueueInit(&q);
    printf("===初始化完成===\n");
    PrintQueue(&q);

    printf("\n===入队 10,20,30,40===\n");
    QueuePush(&q, 10);
    QueuePush(&q, 20);
    QueuePush(&q, 30);
    QueuePush(&q, 40);
    PrintQueue(&q);

    printf("\n===出队两次===\n");
    QueuePop(&q);
    PrintQueue(&q);
    QueuePop(&q);
    PrintQueue(&q);

    printf("\n===入队 50,60===\n");
    QueuePush(&q, 50);
    QueuePush(&q, 60);
    PrintQueue(&q);

    printf("\n===全部出队直到空===\n");
    while (!QueueEmpty(&q))
    {
        QueuePop(&q);
        PrintQueue(&q);
    }

    printf("\n===空队列重新入队 77===\n");
    QueuePush(&q, 77);
    PrintQueue(&q);

    QueueDestroy(&q);
    printf("\n===队列销毁完毕===\n");
    return 0;
}
7.2 运行结果
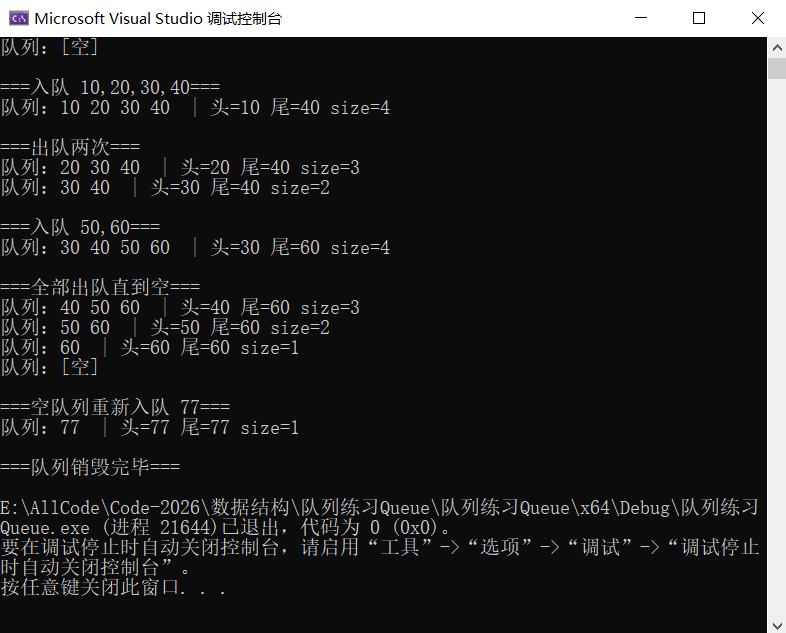
八、复杂度分析
| 操作 | 时间复杂度 |
|---|---|
| QueuePush(入队) | O(1) |
| QueuePop(出队) | O(1) |
| QueueFront(取队头) | O(1) |
| QueueBack(取队尾) | O(1) |
| QueueSize(求长度) | O(1) |
| QueueEmpty(判空) | O(1) |
| QueueDestroy(销毁) | O(N) |
销毁操作必须遍历释放所有节点,时间复杂度最低为 O(N)。
九、拓展:去掉 size 后的变化
如果移除size成员,结构体变为:
typedef struct Queue {
	QueueNode* front;
	QueueNode* rear;
} Queue;
产生的影响:
- QueueEmpty 不受影响:仍可通过
front == NULL判空,保持 O(1) - QueueSize 性能下降:必须从头遍历链表计数,时间复杂度退化为 O(N)
- 入队出队代码简化:无需维护 size 的加减操作
简单说:size最大的价值,就是把「求长度」从线性遍历变成了常数时间。
写在最后
从顺序栈到链式队列,核心都是「操作受限的线性表」,但实现思路差异显著:
- 顺序栈靠「数组 + top 下标」发挥尾插尾删的优势
- 链式队列靠「单链表 + 双指针 + size」适配头删尾插的特性
比起死记代码,更值得沉淀的是三点:
- 数据结构选型要匹配操作场景,没有绝对最优,只有最合适
- 链式结构最容易出错的永远是边界:0个节点、1个节点
- 写数据结构本质是维护「不变量」,每一次操作后,结构的状态规则必须始终成立